이 시리즈는 실제 경험을 바탕으로, 현재 상태를 저장하는 방식의 문제와 이를 해결할 대안들을 살펴봅니다. 각 대안의 장단점과 트레이드오프를 비교해 Event Sourcing을 선택한 이유를 설명합니다. 이어서 그 선택으로 감수한 비용과 제약을 짚고, 이를 보완하기 위해 최종적으로 CQRS를 선택한 과정까지 다룹니다.
이번 편은 시리즈의 다섯 번째 이야기로, 조회마다 반복하던 상태 복원과 정책 계산을 줄이기 위해 조회 모델을 분리하는 과정을 살펴봅니다. 조회 모델의 갱신 방식과 저장소를 비교하고, OpenSearch를 선택한 이유를 설명합니다. 데이터와 규모는 구조를 설명하기 위한 예시입니다.
4편에서는 이벤트에서 상태를 복원하고 정책과 결합해 조회 시점마다 금액을 계산하는 비용을 살펴봤다. 조회 범위와 요청량이 커지면 반복되는 읽기와 계산이 응답 지연과 자원 경합으로 이어질 수 있었다. 이번에는 조회에 필요한 결과를 미리 계산해 저장하고, 그 결과를 조회 목적에 맞게 관리하는 구조를 검토한다.
CQRS로 조회 모델을 분리한다
요청마다 하던 계산을 조회 모델 갱신 시점으로 옮긴다
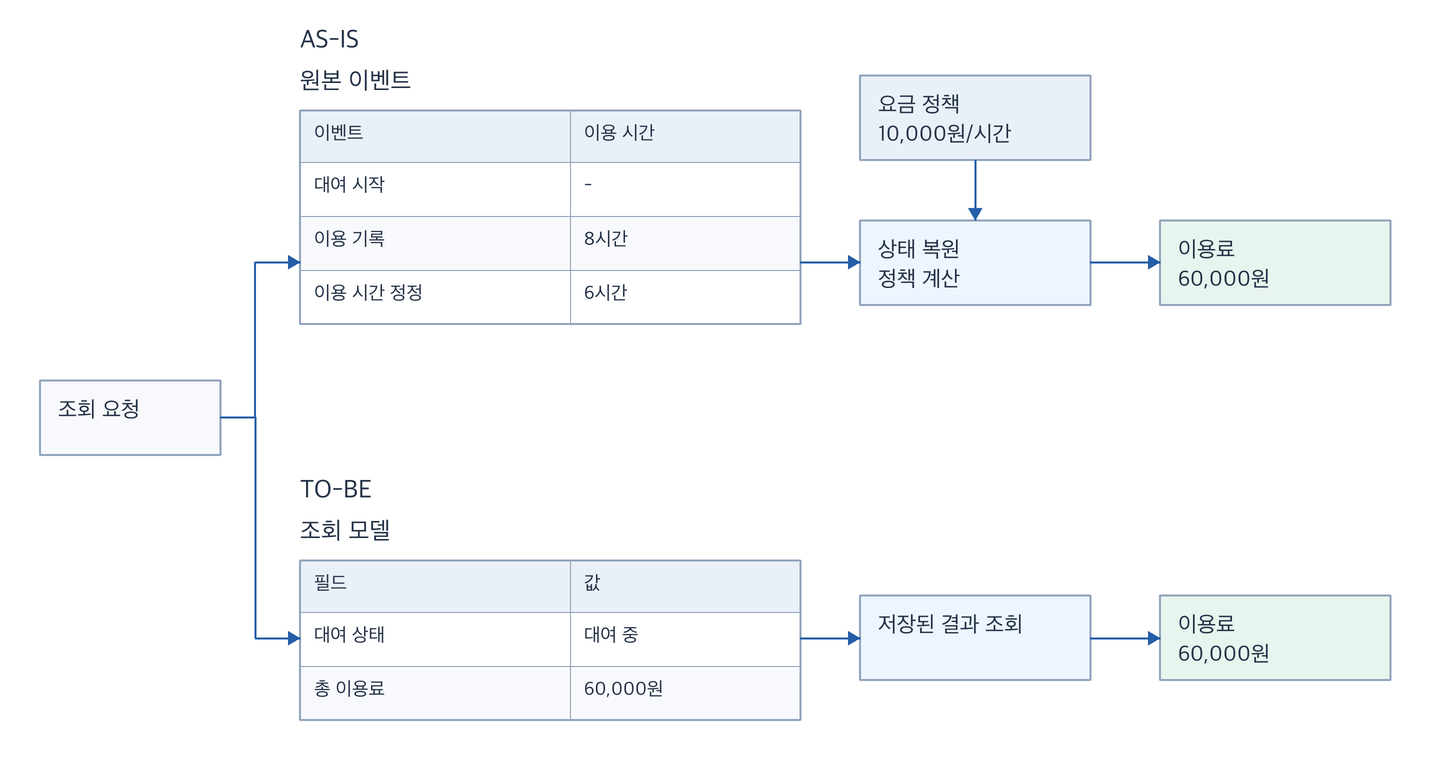
목록에서 필요한 값은 현재 대여 상태와 총 이용료다. 이벤트에서 대여 상태와 이용 시간을 복원하고 정책과 결합해 이용료를 계산한 뒤, 그 결과를 별도로 저장해 두면 목록 요청에서는 저장된 값을 읽을 수 있다. 이처럼 조회 목적에 맞게 구성한 데이터를 조회 모델(Read Model)이라고 하고, 원본에서 조회 모델을 만들거나 갱신하는 과정을 프로젝션(Projection)이라고 한다.
이용 시간을 8시간으로 기록했다가 6시간으로 정정했고, 시간당 요금이 10,000원이라고 해보자. 기존 조회는 매번 이벤트를 적용해 6시간을 구하고 이용료 60,000원을 계산했다. 조회 모델을 추가하면 정정이 발생했을 때 결과를 계산해 저장하고, 이후 조회에서는 저장된 60,000원을 읽는다.
이벤트가 추가되거나 적용 정책이 바뀌면 해당 조회 모델을 다시 계산한다. 원본이 같고 조회 모델에 반영까지 끝났다면, 목록 요청이 반복돼도 같은 이벤트를 다시 복원하고 이용료를 계산할 필요가 없다. 상태 복원과 정책 계산을 조회 요청마다 수행하던 구조에서, 원본 변경에 따라 조회 모델을 갱신할 때 수행하는 구조로 바뀐 것이다.
쓰기와 조회의 모델을 분리한다
계약 승인과 반납, 이용 시간 정정은 원본 상태를 확인하고 변경 가능 여부를 판단한 뒤 이벤트로 확정한다. 목록과 집계는 조회에 필요한 현재 상태와 계산 결과를 사용한다. 변경의 유효성을 판단하는 모델과 결과를 검색하는 모델을 각각의 목적에 맞게 분리하는 것이 CQRS(Command Query Responsibility Segregation)다. Microsoft 공식 문서에서도 다음과 같이 정의한다.
Segregate the read and write operations for a data store into separate data models. — Microsoft, CQRS pattern
쓰기와 읽기에 서로 다른 데이터 모델을 사용한다는 뜻이다. 이 서비스에서는 쓰기 모델이 이벤트와 정책을 기준으로 변경을 처리하고, 조회 모델은 여기서 계산한 현재 상태와 이용료를 저장한다. 원본 기록이 남으므로 조회 모델을 잃어도 원본에서 다시 구성할 수 있다. 여기서 만드는 조회 모델에는 목록의 필터링과 정렬, 집계에 바로 사용할 값을 담는다.
장점
- 조회 요청에서 반복되는 원본 읽기와 계산을 줄인다. 목록을 열 때마다 후보 전체의 이벤트를 복원하는 대신, 저장된 현재 상태와 이용료로 조회 대상을 판단한다. 조회 요청을 처리하는 애플리케이션의 데이터 전송과 역직렬화, 계산 부담이 줄어든다.
- 조회 목적에 맞게 데이터를 구성할 수 있다. 상태와 이용료뿐 아니라 검색에 필요한 지점과 장비 종류도 함께 저장한다. 조회 조건을 처리하기 위해 원본의 여러 기록을 매번 조합하는 작업을 줄일 수 있다.
단점
- 조회 모델을 저장하고 갱신하는 비용이 추가된다. 이벤트나 정책이 바뀌면 영향을 받는 조회 결과도 갱신해야 한다. 정책 소급 적용의 대상이 많으면 조회 모델에 대한 대량 재계산과 쓰기가 필요하다.
- 원본과 조회 모델의 반영 시점을 관리해야 한다. 조회 모델을 언제 갱신하는지에 따라 쓰기 응답 시간과 조회 결과의 최신성이 달라진다. 갱신에 실패한 경우에도 다시 반영할 수 있어야 한다.
조회 모델을 언제 갱신할까?
원본 변경 요청 안에서 함께 동기적으로 갱신하는 방식
변경 요청이 원본을 저장한 뒤 조회 모델까지 갱신하고 응답하는 방식이다. 원본과 조회 모델이 같은 MySQL에 있다면 두 변경을 하나의 트랜잭션으로 묶을 수도 있다. 이 경우 커밋된 원본과 조회 결과를 함께 확정할 수 있다는 장점이 있다.
그 대신 변경 요청의 처리 시간에 조회 모델 계산과 저장 시간이 포함된다. 정책 소급 적용으로 조회 모델 100만 건을 바꿔야 한다면, 전체 갱신이 쓰기 요청의 응답 경로에 들어간다. 다른 저장소에 조회 모델을 둔다면 두 저장소 사이의 실패도 별도로 다뤄야 한다.
원본 변경 후 비동기로 갱신하는 방식
원본 변경과 갱신에 필요한 기록을 확정한 뒤 응답하고, 별도의 워커가 원본을 읽어 조회 모델을 갱신하는 방식이다. 이 서비스에서는 목록과 집계에 반영 지연을 허용하고, 승인과 정정 같은 변경 판단에는 원본 상태를 사용한다는 기준을 두고 이 방식을 선택했다.
장점은 조회 모델 갱신을 기다리지 않고 원본 변경 요청을 완료할 수 있다는 것이다. 소급 적용 대상이 많으면 워커가 대상을 나눠 처리하고, 조회 저장소의 부하에 맞춰 동시 처리 수를 조절할 수 있다.
그 대신 원본이 확정된 뒤에도 목록에는 이전 값이 보일 수 있고, 갱신 요청의 누락과 실패, 중복 처리를 관리해야 한다. 변경이 더 발생하지 않고 미반영된 갱신이 정상적으로 처리되면, 조회 모델은 원본에서 계산한 결과로 수렴한다. 이를 결과적 일관성(Eventual Consistency)이라고 한다.
3편에서 없앤 것은 정책 변경에 따른 원장의 대량 갱신이다. 조회 모델에 계산 결과를 저장하면, 그 결과를 최신화하는 쓰기는 다시 필요하다. 이 구조에서는 그 쓰기를 원본 변경 요청에서 분리하고 비동기로 처리한다. 여러 대상의 갱신이 진행되는 동안 목록과 집계에는 정책 반영이 끝난 결과와 아직 갱신하지 않은 결과가 함께 존재할 수 있다.
조회 저장소를 선택한다
필요한 조회 조건
이용료순 목록에 더해 다음 조회를 지원한다고 가정한다. 지점과 장비 종류는 필터와 집계 조건이 확장되는 상황을 설명하기 위한 분류다.
| 구분 | 요구사항 |
| 필터링 | 생성 기간, 대여 상태, 지점, 장비 종류, 이용료 범위를 조합한다. |
| 정렬 | 생성일 또는 총 이용료를 기준으로 정렬하고 목록을 20개씩 조회한다. |
| 집계 | 조건에 맞는 계약 수와 이용료 합계, 지점별 또는 장비 종류별 분포를 확인한다. |
| 조건 확장 | 필터를 추가하거나 기존 필드를 다른 집계 기준으로 조합할 수 있다. |
예를 들어 대여 중인 계약을 지점으로 좁히고 이용료순으로 조회하면서, 같은 조건에 해당하는 장비 종류별 계약 수와 이용료 합계도 확인한다. 저장소를 선택할 때는 이런 조건 조합을 어떻게 처리하는지, 그 과정에서 어떤 색인과 저장 비용이 드는지를 비교해야 한다.
MySQL
MySQL에 조회용 테이블을 만들면 저장된 상태와 총 이용료에 인덱스를 구성해 목록을 조회할 수 있다. SQL로 필터링과 정렬, 집계를 처리할 수 있고, 원본과 같은 저장소를 사용하면 운영할 시스템이 늘어나지 않는다는 장점도 있다.
하지만 이번 요구에서는 필터와 정렬, 집계 조건이 계속 추가되고 조합도 늘어난다. 이를 인덱스 추가로 계속 대응하기에는 비용이 따른다. 인덱스마다 저장 공간이 필요하고, 데이터가 변경되면 관련 인덱스도 함께 갱신해야 한다. 따라서 조회 성능을 높이기 위해 인덱스를 늘릴수록 저장 비용과 쓰기 부하, 인덱스 관리 부담이 커진다. MySQL 공식 문서에서도 다음과 같이 설명한다.
Indexes also add to the cost of inserts, updates, and deletes because each index must be updated. — MySQL, Optimization and Indexes
데이터 변경 시 인덱스도 갱신해야 하므로 쓰기 비용이 추가된다는 뜻이다. 특히 이 서비스에서는 정책 소급 적용으로 조회 모델의 이용료를 대량 갱신한다. 이용료와 관련된 인덱스가 많아지면 이 작업의 인덱스 유지 비용도 커진다. 조회 요구의 확장에 맞춰 인덱스를 계속 추가하는 선택은 대량 갱신 비용과도 함께 평가해야 했다.
이번에 중요하게 본 것은 조회 조건과 집계 기준이 늘어나도 인덱스 구성을 계속 확대하고 조정하는 부담을 줄일 수 있는가였다. 이 요구에서는 인덱스 추가와 쿼리별 최적화에 지속적으로 의존하는 방식이 적합하지 않다고 판단해, MySQL을 조회 저장소 후보에서 제외했다.
MongoDB
MongoDB에서는 현재 상태와 이용료, 지점과 장비 종류를 하나의 문서에 담고 필터링과 정렬, 집계를 수행할 수 있다. 문서 구조를 확장하기 쉽다는 장점이 있지만, 정렬 성능은 조회 조건에 맞는 인덱스 구성에 영향을 받는다. 여러 필드의 정렬을 인덱스로 처리하려면 조회 조건에 맞는 복합 인덱스가 필요하다.
이번 요구에서는 문서 형식 자체보다 검색과 집계 조건을 조합하는 방식이 선택의 기준이었으므로, 다음의 OpenSearch 구조에 무게를 뒀다.
OpenSearch
필요했던 것은 여러 필터 조건을 조합하고 확장하면서, 이용료순 정렬과 다양한 기준의 집계를 함께 처리하는 것이었다. OpenSearch는 이를 위한 검색 구조와 필드 값 저장 구조를 제공한다.
역 인덱스로 필터 조건을 조합한다
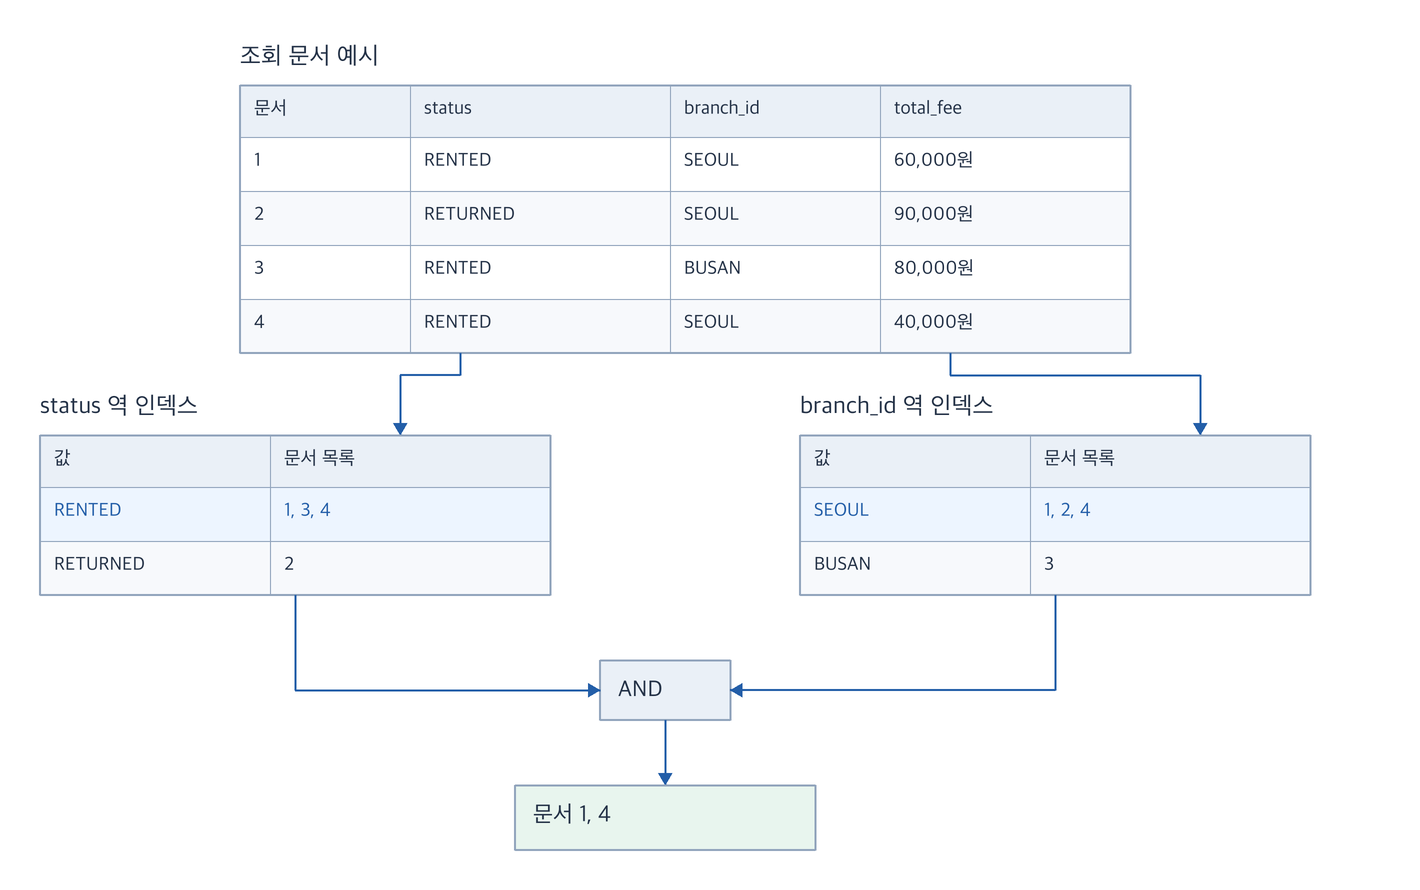
상태와 지점 같은 keyword 필드의 정확한 값으로 필터링할 때는 역 인덱스를 사용한다. 역 인덱스는 값과 그 값을 포함하는 문서 목록을 연결한 구조다. 대여 중인 문서 목록과 서울 지점 문서 목록을 조합하면 두 조건을 모두 만족하는 대상을 찾을 수 있다. 기존에 색인한 필드라면 장비 종류 같은 조건을 더할 때도 해당 필드의 문서 목록을 함께 조합하므로, 조건 조합마다 별도의 복합 인덱스를 추가하는 부담을 줄일 수 있다.
공식 문서에서도 이를 “a mapping of terms to the documents that contain them”이라고 설명한다. 값에서 해당 문서들을 찾을 수 있도록 연결한다는 뜻이다. — OpenSearch, Index mapping parameter
Doc Values로 정렬과 집계에 필요한 값을 읽는다
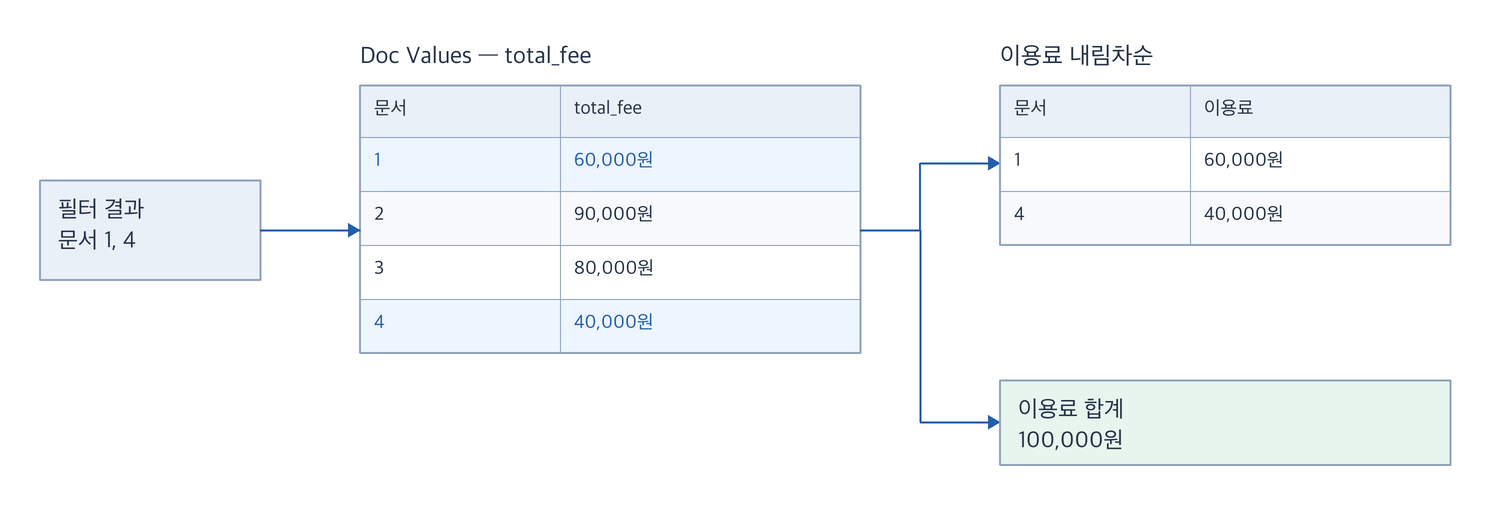
이용료순으로 정렬하거나 지점별 이용료를 합산하려면, 조건에 맞는 문서의 이용료와 지점 값을 읽어야 한다. Doc Values는 문서별 필드 값을 필드 단위의 컬럼 형태로 저장한 구조다. 정렬에서는 이용료 값을 읽어 순서를 비교하고, 지점별 집계에서는 지점 값으로 그룹을 나눈 뒤 이용료를 합산한다. 필요한 필드 값을 이 구조에서 읽으므로 문서의 원본 JSON 전체를 파싱하는 부담을 줄일 수 있다.
공식 문서의 “in columns, one per field”도 필드마다 별도의 컬럼 형태로 저장한다는 뜻이다. 같은 필드를 정렬이나 서로 다른 집계 기준으로 활용할 수 있어, 조회 요구가 늘어나는 상황에 적합했다. — OpenSearch, Doc values mapping parameter
최종 구조와 조회 흐름
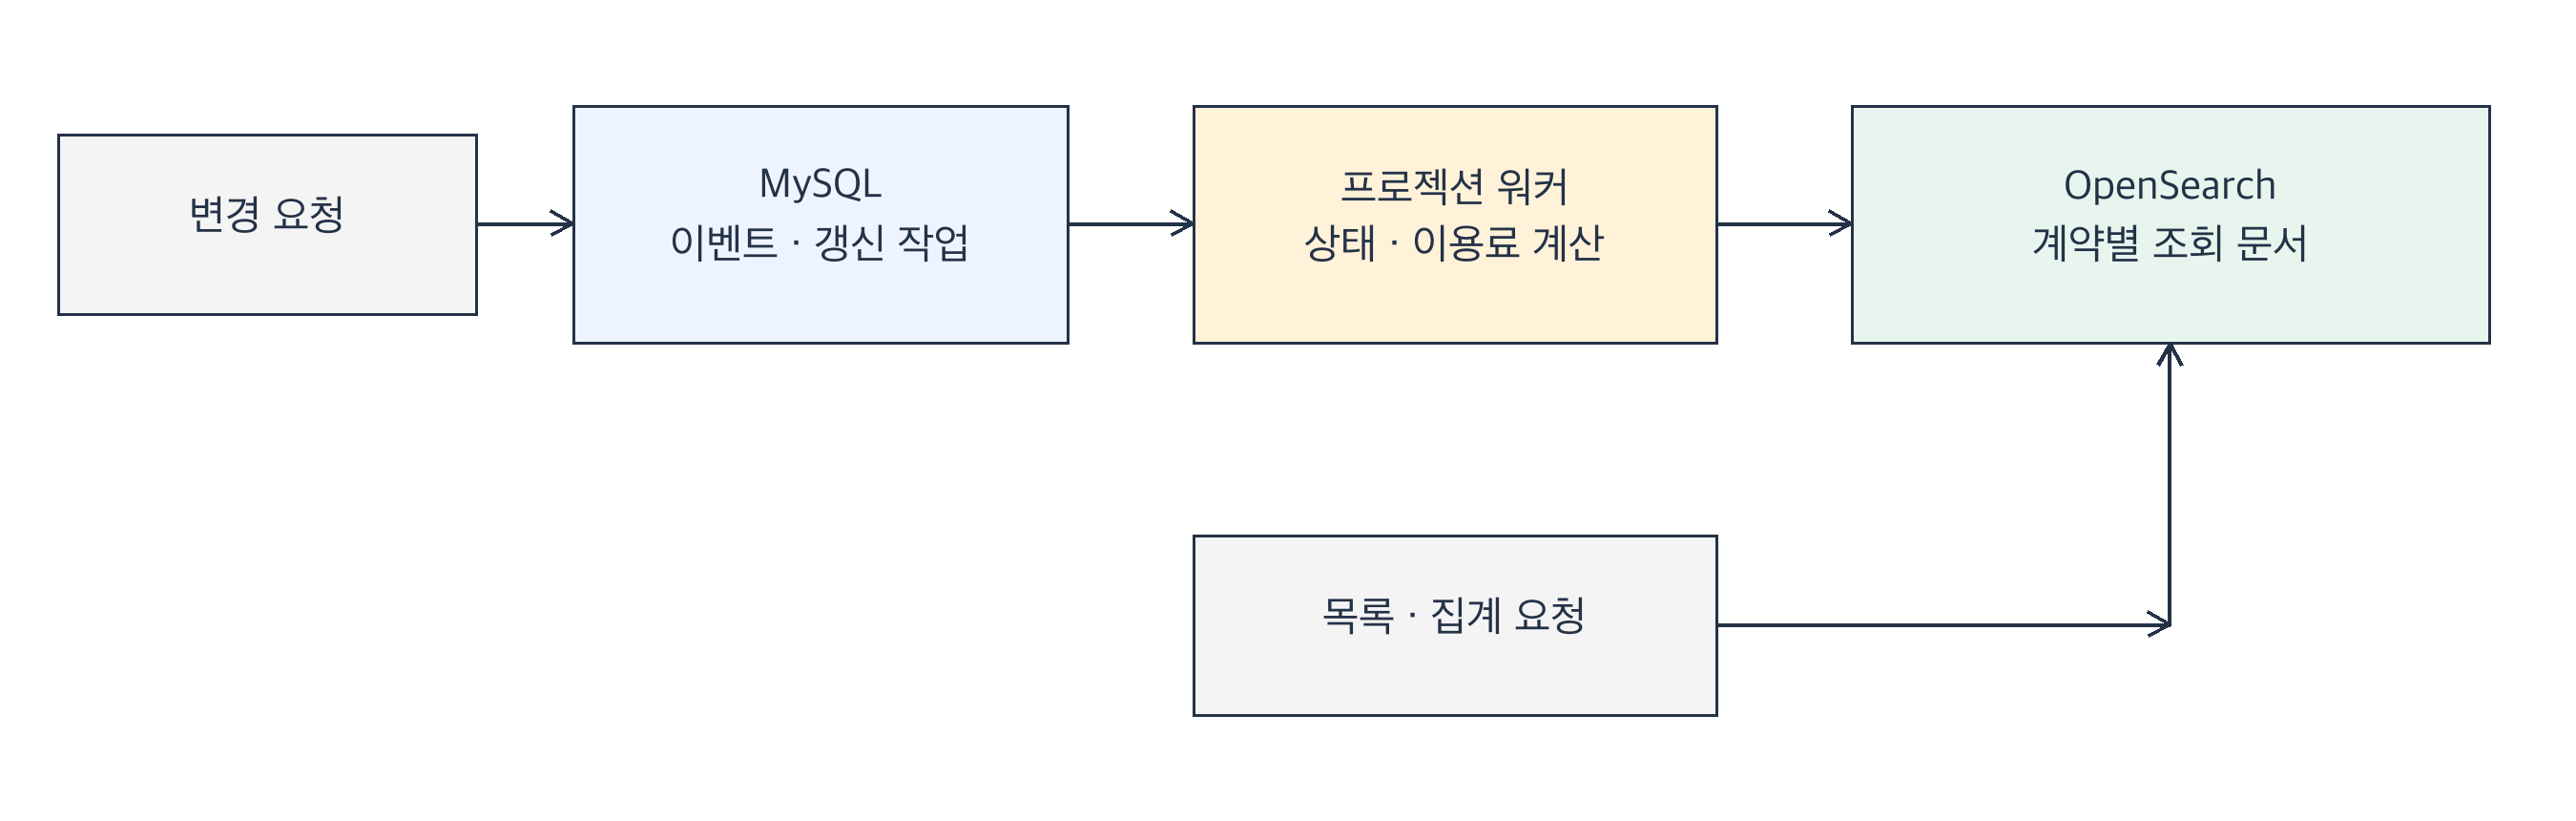
변경 요청은 MySQL의 원본 상태를 기준으로 판단하고 이벤트나 정책 변경을 확정한다. 갱신에 필요한 기록을 바탕으로 프로젝션 워커가 영향을 받는 대상을 읽고 현재 상태와 이용료를 계산해 OpenSearch에 저장한다. 목록과 집계 요청은 이 조회 모델을 사용한다. 계약별 조회 문서에는 다음과 같이 현재 상태와 계산 결과, 검색에 필요한 값을 함께 담을 수 있다. 예시에서는 식별자와 분류 필드를 keyword, 생성일을 date, 총 이용료를 long으로 매핑하고, 금액은 원 단위 정수로 저장한다.
{
  "rental_id": "rental-101",
  "created_at": "2025-03-10T09:00:00+09:00",
  "status": "RENTED",
  "branch_id": "SEOUL",
  "equipment_type": "CAMERA",
  "total_fee": 60000
}
4편과 같은 ‘2025년에 생성한 대여 중 계약을 이용료가 높은 순서로 20개’ 조회는 다음과 같이 요청한다. 같은 조건의 이용료 합계를 확인하기 위해 집계도 함께 추가했다.
GET rental-read/_search
{
  "size": 20,
  "query": {
    "bool": {
      "filter": [
        { "term": { "status": "RENTED" } },
        {
          "range": {
            "created_at": {
              "gte": "2025-01-01T00:00:00+09:00",
              "lt": "2026-01-01T00:00:00+09:00"
            }
          }
        }
      ]
    }
  },
  "sort": [
    { "total_fee": "desc" },
    { "rental_id": "asc" }
  ],
  "aggs": {
    "total_fee_sum": {
      "sum": { "field": "total_fee" }
    }
  }
}
목록은 저장된 상태와 이용료를 기준으로 필터링하고 정렬하며, 집계는 같은 조회 조건에 맞는 전체 문서의 이용료를 합산한다. OpenSearch는 후보 검색과 정렬, 집계를 수행하고, 애플리케이션은 목록 결과와 집계 결과를 받아 응답한다.
정리
기존에는 원본 상태를 복원한 뒤 정책과 결합해 조회 시점마다 금액을 계산했다. 조회 모델을 분리한 뒤에는 이 계산을 갱신 시점에 수행하고, 목록과 집계 요청은 미리 계산된 현재 값을 사용하도록 바뀌었다. 변경의 유효성을 판단하는 쓰기 모델과 검색에 필요한 결과를 제공하는 조회 모델을 각각의 요구에 맞게 구성한 것이 이번에 적용한 CQRS의 핵심이다.
조회 조건과 집계 기준이 계속 늘어나는 요구에는 역 인덱스 기반의 필드별 검색 구조와 Doc Values를 활용할 수 있는 OpenSearch를 선택했다. 조회 모델의 갱신은 비동기로 처리해, 정책 변경 요청이 대량 재계산과 쓰기의 완료를 기다리지 않고 응답하도록 했다.
그 대가로 원본 변경의 확정과 조회 결과의 반영 사이에 시차가 생긴다. 쓰기 요청이 성공한 뒤에도 해당 변경이 조회 모델에 빠짐없이 반영되도록 보장하는 비용이 추가된 것이다. 다음 편에서는 비동기 전달과 갱신 과정에서 발생하는 누락과 중복, 순서 역전에 대응하는 방법을 살펴본다.
'Engineering' 카테고리의 다른 글
| Event Sourcing에서 CQRS까지 (6) - 비동기 프로젝션의 장애와 복구 (0) | 2026.10.15 |
|---|---|
| Event Sourcing에서 CQRS까지 (4) - 트레이드오프 (0) | 2026.10.15 |
| Event Sourcing에서 CQRS까지 (3) - 대량 쓰기 문제의 해결 (0) | 2026.10.15 |
| Event Sourcing에서 CQRS까지 (2) - 이력 보존 문제의 해결 (0) | 2026.10.09 |
| Event Sourcing에서 CQRS까지 (1) - 문제 정의 (0) | 2026.10.09 |