이 시리즈는 실제 경험을 바탕으로, 현재 상태를 저장하는 방식의 문제와 이를 해결할 대안들을 살펴봅니다. 각 대안의 장단점과 트레이드오프를 비교해 Event Sourcing을 선택한 이유를 설명합니다. 이어서 그 선택으로 감수한 비용과 제약을 짚고, 이를 보완하기 위해 최종적으로 CQRS를 선택한 과정까지 다룹니다.
이번 편은 시리즈의 마지막 이야기로, 비동기 반영 과정의 누락과 중복, 순서 역전에 대응하는 방법을 살펴봅니다. 원본 변경을 전달하는 구간과 조회 모델에 반영하는 구간을 나눠, 각 단계의 장애와 복구 방식을 설명합니다.
5편에서는 조회할 때마다 원본 이벤트에서 상태를 복원하고 정책과 결합해 금액을 계산하던 처리를 조회 모델 갱신 시점으로 옮겼다. 목록의 필터링과 정렬, 집계는 계산 결과를 저장한 OpenSearch에서 처리한다. 원본 변경은 RDB에 확정하고, 조회 모델 갱신은 Kafka를 통해 비동기로 실행해 쓰기 요청이 조회 모델 갱신까지 기다리지 않도록 했다.
이 구조에서는 원본 저장이 성공해도 조회 모델 반영까지 성공했다고 볼 수 없다. DB에 커밋한 직후 애플리케이션이 종료되면 변경을 전달하지 못할 수 있고, OpenSearch에는 반영됐지만 성공 여부를 확인하지 못하면 같은 작업을 다시 실행할 수도 있다. 지연된 이전 요청이 최신 결과를 덮어쓰는 상황도 고려해야 한다.
비동기 반영에 따른 일시적인 지연은 감수하더라도, 변경이 누락되거나 잘못 반영된 상태로 남아서는 안 된다. 이번 편에서는 RDB에서 Kafka로 변경을 전달하는 구간과 OpenSearch에 반영하는 구간을 나누어, 각 구간에서 예상되는 장애 상황과 해결책을 살펴본다.
비동기 반영의 두 구간
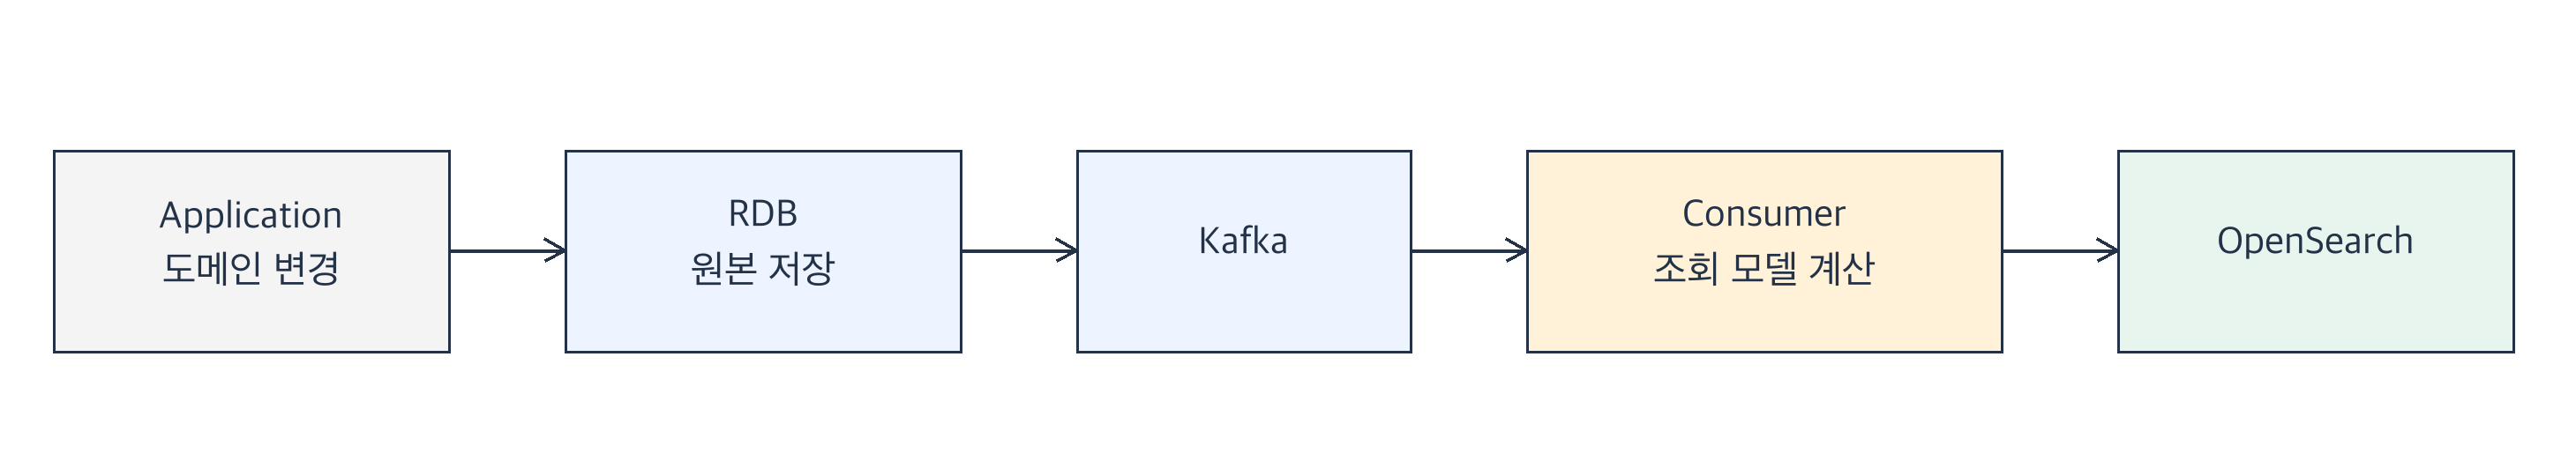
DB 커밋과 Kafka 발행, OpenSearch 갱신은 별개로 성공하거나 실패할 수 있다. 각 구간에서 처리를 완료했다고 판단하는 기준과 장애 후 재처리 방식을 정해야 한다.
1. RDB → Kafka
DB에 확정된 변경을 Kafka에 빠짐없이 전달해야 한다. DB 커밋과 Kafka 발행 사이의 장애가 누락으로 이어질 수 있다.
RDB에는 커밋됐지만 Kafka 발행에 실패한 경우
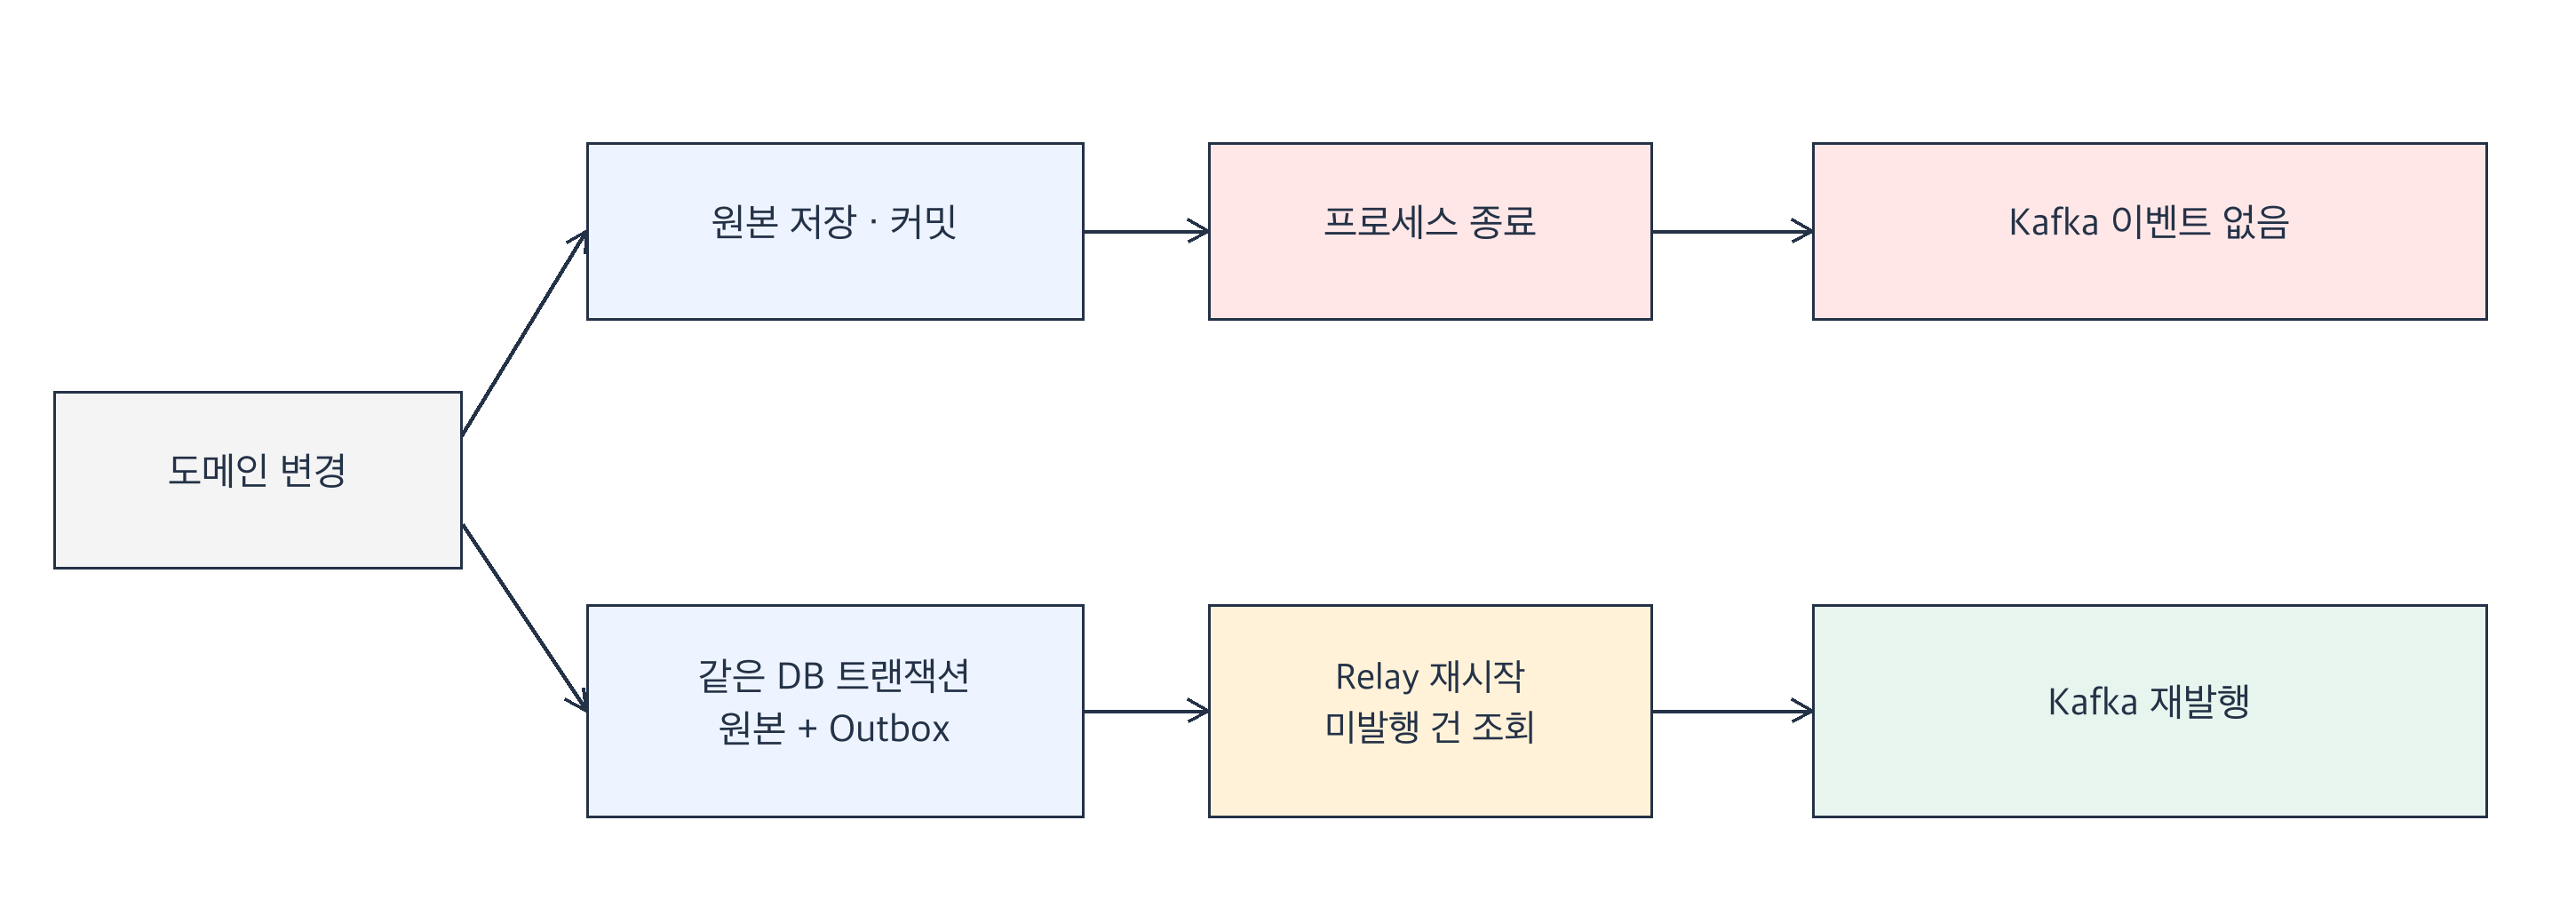
시간당 요금이 10,000원인 이용 내역의 시간을 8시간에서 6시간으로 정정했다고 해보자. RDB에는 변경이 커밋됐지만 Kafka로 이벤트를 보내기 전에 애플리케이션이 종료됐다. 발행 요청 중 네트워크 장애로 Kafka에 전달하지 못한 경우도 같다. 원본은 바뀌었는데 컨슈머가 받을 이벤트가 없으므로, OpenSearch에는 이전 이용료 80,000원이 계속 표시된다.
Outbox 패턴은 원본 이벤트 또는 정책 변경과 발행할 메시지를 같은 DB 트랜잭션으로 저장한다. 별도의 발행 프로세스인 Relay가 Outbox를 읽어 Kafka에 보내고, 발행 성공 후 완료로 표시한다. 애플리케이션이 종료돼도 미발행 메시지가 DB에 남으므로 다시 발행할 수 있다.
중복으로 재발행되는 경우
Outbox로 발행할 기록을 보존해도 같은 이벤트가 다시 발행될 수 있다. - Kafka에는 이벤트가 저장됐지만 네트워크가 끊겨 Relay가 성공 응답을 받지 못한다. - 발행은 성공했지만 Relay 종료나 DB 장애로 Outbox에 완료를 기록하지 못한다.
두 경우 모두 Outbox에는 미완료로 남으므로 같은 이벤트를 다시 발행한다. 전달 여부가 불확실한 메시지를 완료 처리하면 실제로 발행되지 않은 변경을 놓칠 수 있기 때문이다. 이처럼 적어도 한 번 전달하되 중복을 허용하는 방식이 at-least-once 전달이다. 컨슈머는 같은 이벤트를 다시 받아도 중복 반영하지 않도록 멱등하게 처리해야 한다. 재발행할 때 같은 이벤트 ID를 유지하면 중복 여부를 식별할 수 있다.
2. Kafka → OpenSearch
OpenSearch 갱신과 Kafka의 처리 위치 커밋 사이에서도 누락과 중복이 발생할 수 있다.
반영 전에 커밋하거나, 반영에 실패한 경우
컨슈머가 Kafka에 처리 위치를 먼저 커밋한 뒤 OpenSearch에 쓰기 전에 종료되면, 재시작해도 해당 이벤트를 다시 받지 않는다. 반영에 실패했는데 예외만 기록하고 커밋한 경우도 같은 누락이 발생한다.
OpenSearch 반영 성공을 확인한 뒤 offset을 커밋해야 한다. 자동 커밋을 끄고, 반영에 실패하면 커밋하지 않고 재시도한다.
OpenSearch에는 반영됐지만 커밋 전에 종료된 경우
OpenSearch 반영 후 offset 커밋 전에 종료되면 재시작 시 같은 이벤트를 다시 처리한다. 저장은 성공했지만 응답을 받지 못해 재시도할 때도 중복 처리가 발생한다.
중복 전달을 고려한 조회 모델의 갱신 파이프라인
중복 처리에 대응하기 위해 증감분을 기존 문서에 적용하는 방식과, 원본에서 현재 상태를 다시 계산해 문서를 교체하는 방식을 비교했다.
이벤트의 증감분을 기존 문서에 반영한다
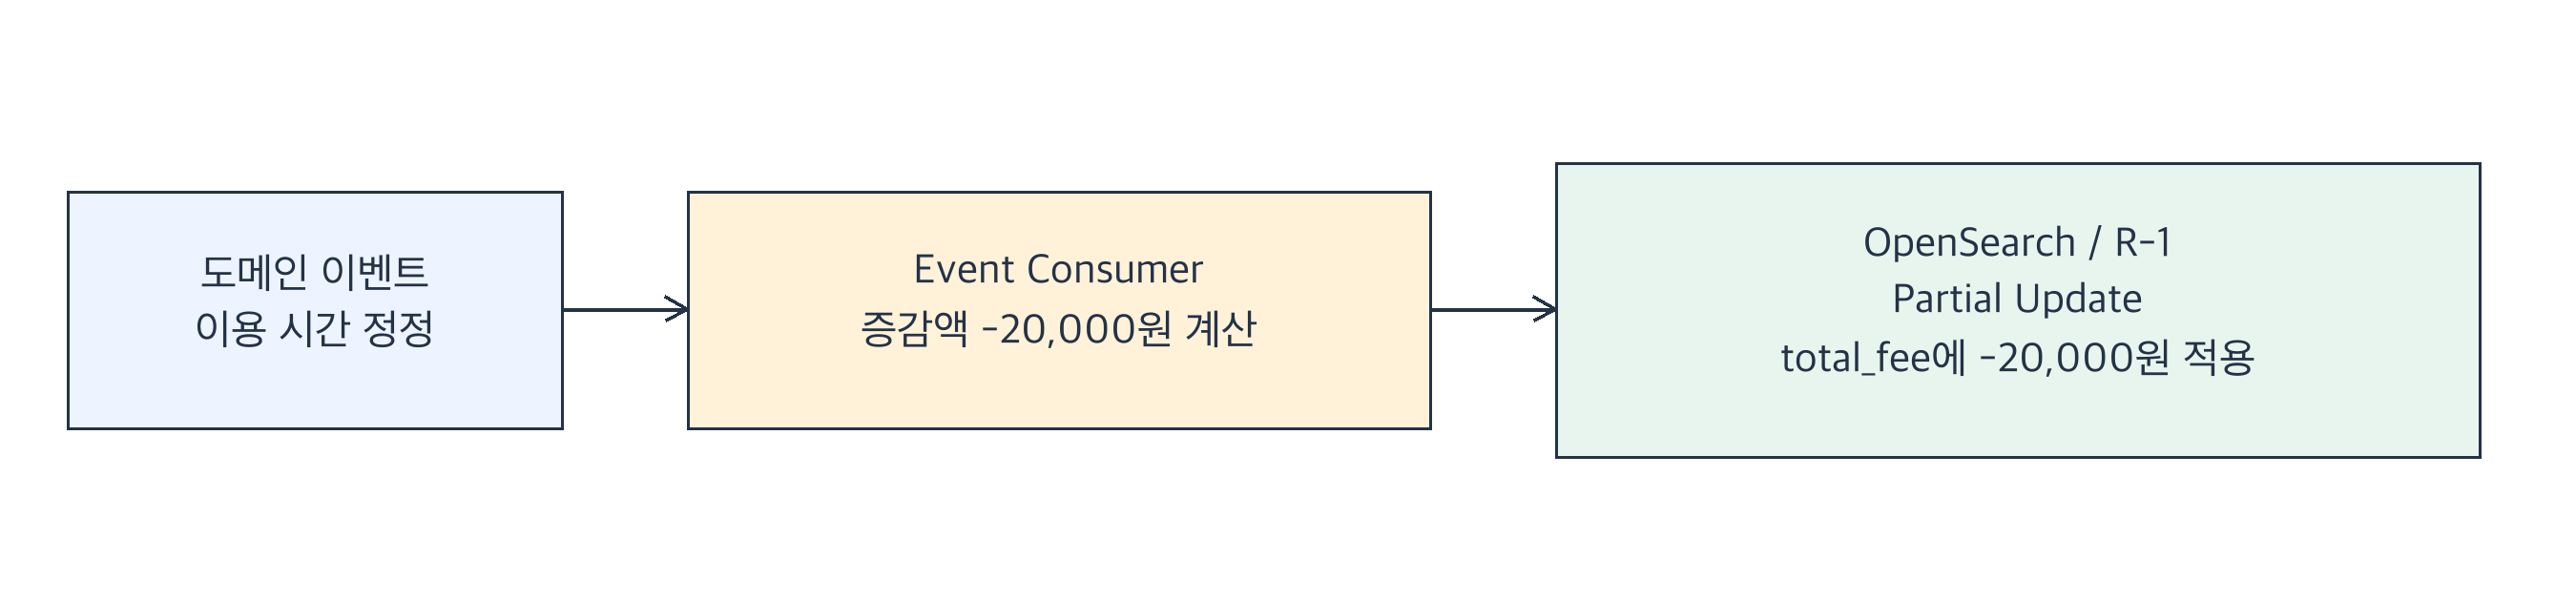
이벤트 컨슈머가 증감분을 계산해 필요한 필드만 갱신한다. 이용 시간을 8시간에서 6시간으로 정정했다면 total_fee에서 20,000원을 차감해 80,000원을 60,000원으로 바꾼다. 하지만 같은 이벤트를 재처리하면 다시 차감해 40,000원이 된다. 한 번의 변경이 조회 문서에 두 번 반영되는 것이다.
처리한 이벤트 ID를 기록해 중복을 걸러낼 수 있지만, 증감분 적용과 처리 완료 기록이 함께 성공하거나 함께 실패해야 한다. 금액만 바꾸고 기록에 실패하면 중복 반영되고, 기록만 남기고 갱신에 실패하면 필요한 반영을 건너뛰게 된다. 처리 이력을 RDB에 따로 저장한다면 OpenSearch 갱신과 하나의 트랜잭션으로 묶을 수 없어 이 사이의 장애에도 대응해야 한다. 여러 필드가 바뀌는 경우에는 필드별 증감 로직도 관리해야 한다.
원본에서 현재 상태를 다시 계산해 문서를 교체한다
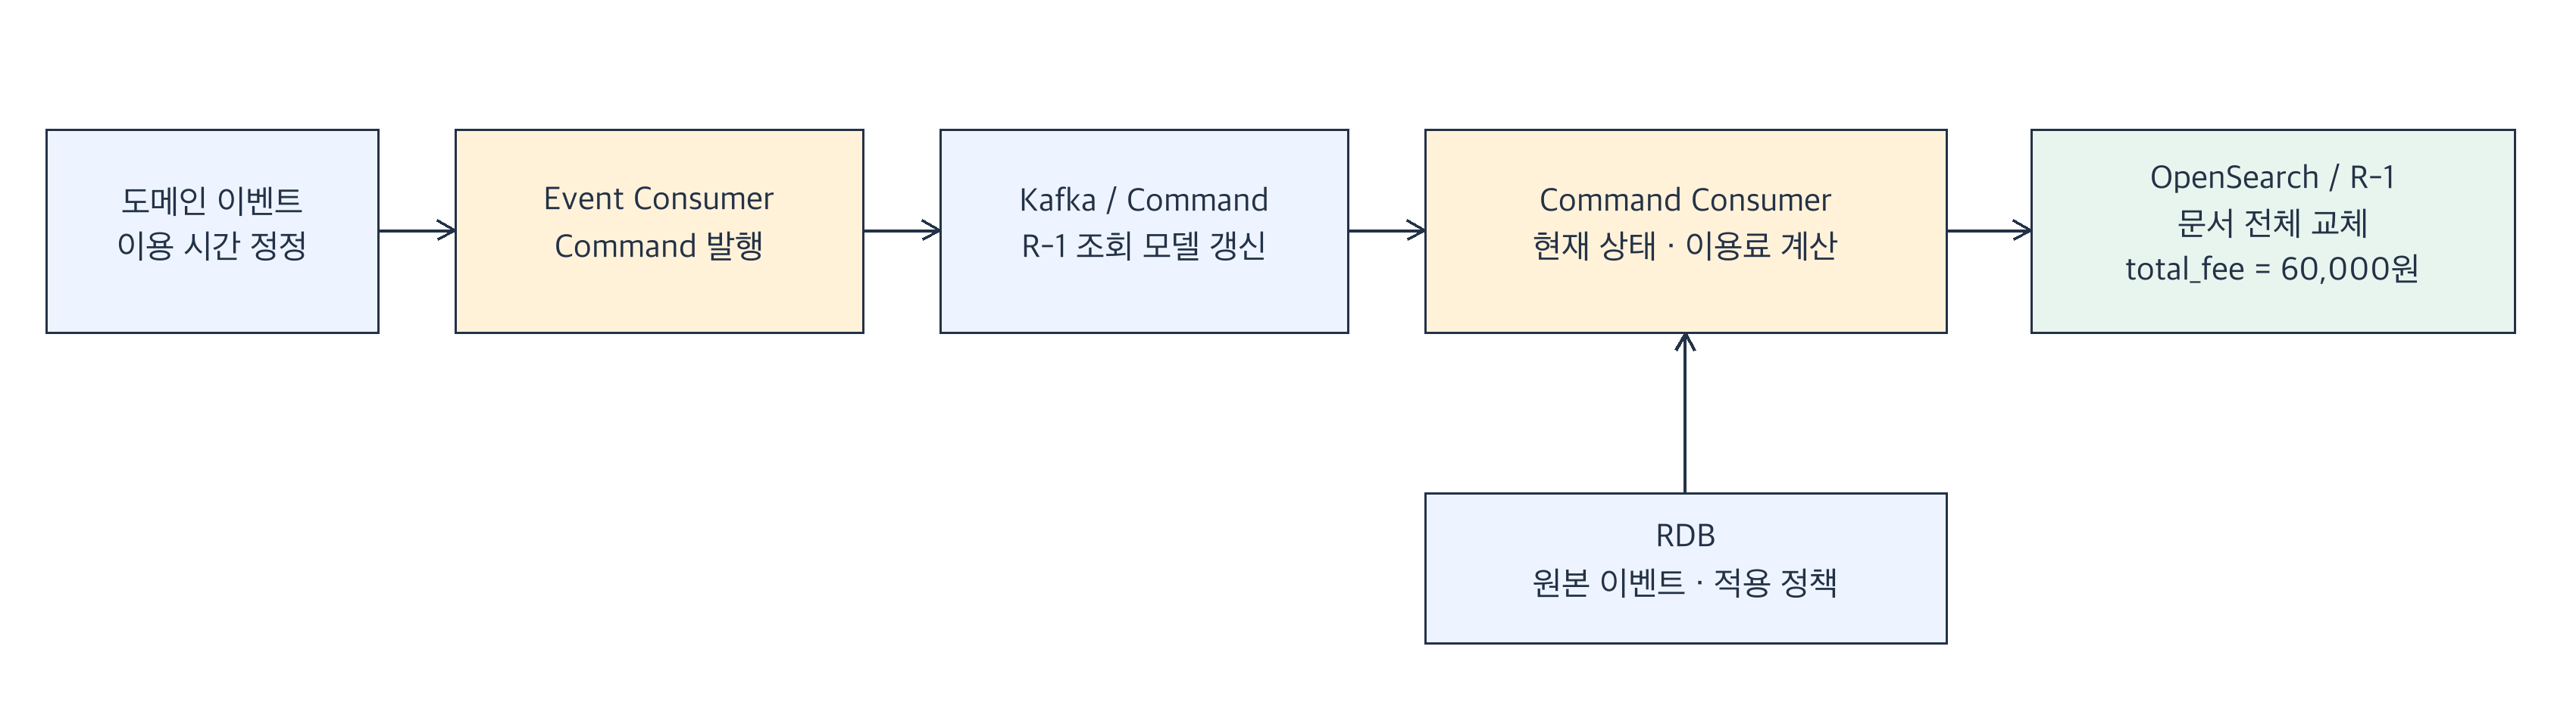
이 방식에서는 이벤트 컨슈머가 변경된 대상을 확인해 ‘해당 계약의 조회 모델을 갱신하라’는 Command를 Kafka에 발행한다. Command 컨슈머는 RDB의 원본 이벤트에서 현재 상태를 복원하고, 정책과 결합해 이용료를 계산한 뒤 OpenSearch 문서 전체를 교체한다. 계약 ID를 문서 ID로 사용하므로 같은 계약의 갱신 요청은 같은 조회 문서에 반영한다.
원본이 6시간이고 시간당 요금이 10,000원이면 같은 Command를 다시 처리해도 60,000원을 저장한다. 원본과 정책이 같으면 같은 결과를 만들고, 변경됐다면 최신 기준으로 다시 계산한다. 갱신에 실패해도 원인을 수정한 뒤 같은 Command로 문서를 재구성할 수 있다. 이벤트별 증감분과 적용 이력을 추적하는 부담을 줄여 재처리와 복구를 단순하게 만들 수 있어 이 방식을 선택했다.
그 대신 Command마다 원본 조회와 전체 계산, 문서 전송을 반복하며, 추가된 발행과 소비 단계의 실패 및 지연을 관리해야 한다. 이벤트 컨슈머는 Command 발행 성공 후, Command 컨슈머는 OpenSearch 반영 성공 후 offset을 커밋한다. 실패 건을 DLQ에 보존해 재처리하는 경우에는 DLQ 저장 성공을 확인한 뒤 커밋한다.
지연된 요청이 최신 문서를 덮어쓰는 경우
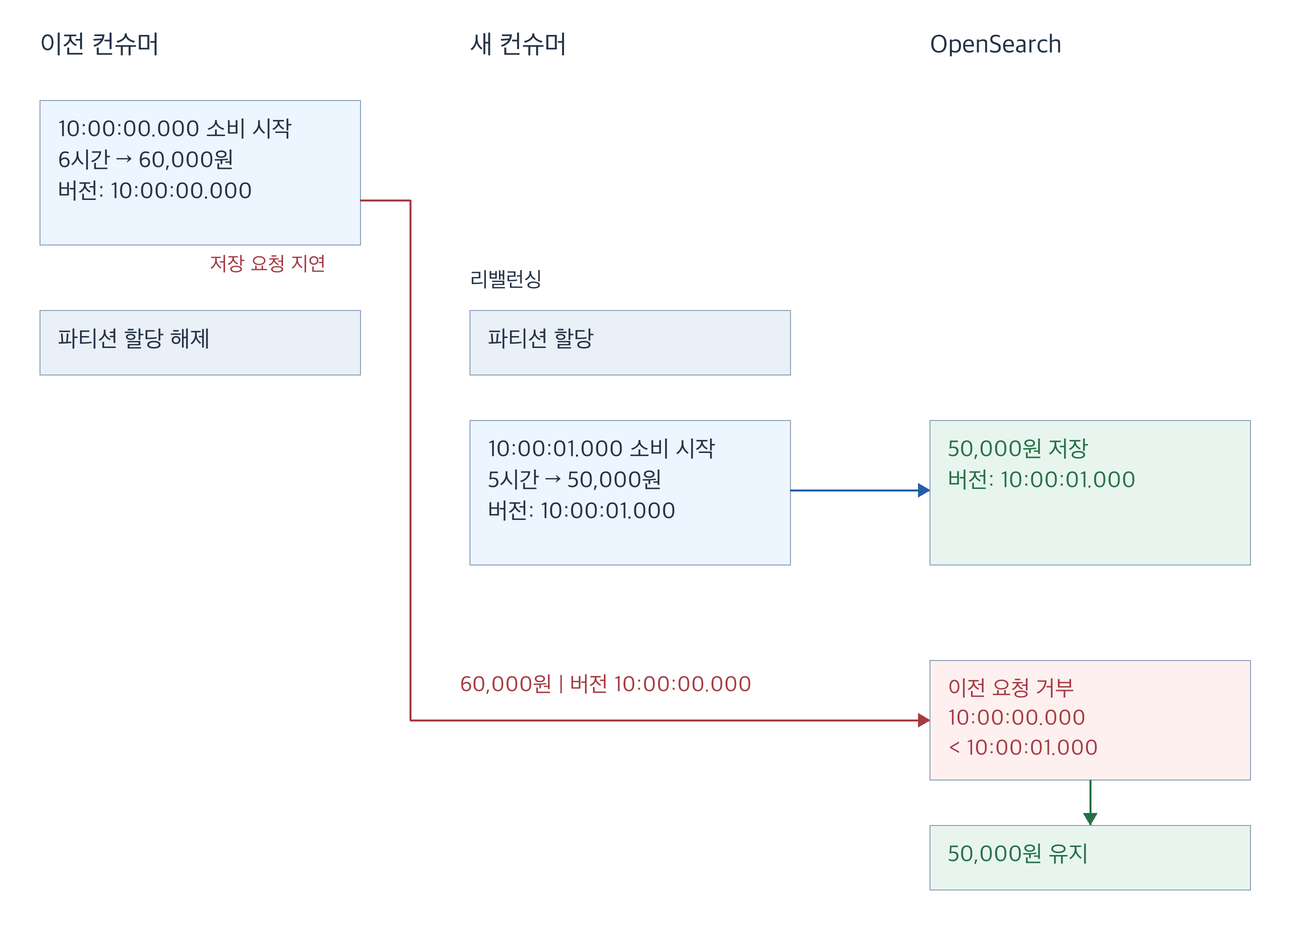
그림은 이용 시간이 6시간에서 5시간으로 정정되는 동안 리밸런싱이 발생한 예시다. 버전의 선후 관계를 쉽게 읽을 수 있도록 긴 숫자 대신 소비 시작 시각으로 표시했다.
같은 계약의 Command는 계약 ID를 Kafka key로 사용해 같은 파티션에 전달하고, OpenSearch 반영까지 직렬로 처리해 저장 순서를 유지한다.
다만 리밸런싱으로 파티션이 다른 컨슈머에 할당될 때는 이전 컨슈머가 보낸 OpenSearch 요청이 남아 있을 수 있다. 새 컨슈머가 최신 상태를 반영한 뒤 이전 요청이 뒤늦게 처리되면, 조회 문서가 과거 값으로 덮어써질 수 있다.
이를 보완하기 위해 각 Command를 소비하기 시작한 시점의 epoch 밀리초를 OpenSearch의 외부 버전으로 사용했다. 원본 조회와 계산 전에 부여한 값을 저장 요청에도 그대로 전달한다. 정책 변경으로 발생한 Command도 같은 방식으로 처리한다.
저장할 때 version_type=external을 지정하면 OpenSearch는 저장된 버전보다 큰 버전만 반영한다. 공식 문서에서도 다음과 같이 설명한다.
Only indexes the document if the specified version is strictly greater than the version of the stored document — OpenSearch, Index Document API
새 컨슈머의 더 큰 버전이 저장된 뒤에는 이전 요청이 버전 충돌로 거부되므로, 조회 문서는 50,000원을 유지한다.
정리
RDB → Kafka에서는 확정된 변경을 빠짐없이 전달하고, Kafka → OpenSearch에서는 재전달된 갱신 Command를 받아도 올바르게 반영해야 한다. 발행할 기록과 실패 건을 보존하고, 장애가 복구된 뒤 미완료 작업을 다시 처리할 수 있어야 원본과 조회 모델을 맞출 수 있다.
이 시리즈에서는 현재 상태를 덮어쓰면서 변경 과정을 잃는 문제에서 출발해 Event Sourcing을 선택하고, 조회 비용을 줄이기 위해 CQRS로 조회 모델을 분리했다. 마지막으로 비동기 반영 과정의 누락과 중복, 순서 역전에 대응하는 방법을 살펴봤다. 이벤트와 정책을 원본으로 유지하고, 조회 모델은 이 원본에서 다시 계산하고 복구할 수 있는 결과로 관리하는 구조다.
'Engineering' 카테고리의 다른 글
| Event Sourcing에서 CQRS까지 (5) - 조회 모델 분리 (0) | 2026.10.15 |
|---|---|
| Event Sourcing에서 CQRS까지 (4) - 트레이드오프 (0) | 2026.10.15 |
| Event Sourcing에서 CQRS까지 (3) - 대량 쓰기 문제의 해결 (0) | 2026.10.15 |
| Event Sourcing에서 CQRS까지 (2) - 이력 보존 문제의 해결 (0) | 2026.10.09 |
| Event Sourcing에서 CQRS까지 (1) - 문제 정의 (0) | 2026.10.09 |